Gemini Omni 1.1 Flash y la transformación del flujo de producción audiovisual
Resumen estructurado: Gemini Omni 1.1 Flash y el flujo audiovisual
El contexto: Google DeepMind redefine la generación de vídeo sintético con Gemini Omni 1.1 Flash, sustituyendo la aleatoriedad por determinismo técnico, coherencia omnimodal nativa y un drástico abaratamiento de costes computacionales.
La introducción de una ventana deslizante de 10 segundos frena la deriva temporal hasta en secuencias continuas de 40 segundos, mientras que la interpolación entre fotogramas clave iniciales y finales rescata la precisión del flujo de animación tradicional.
El renderizado en 360p reduce el coste a unos 0,03 $ por segundo y acelera los tiempos en un 60%, permitiendo iterar decenas de planos en storyboards rápidos antes de escalar a 720p, 1080p o 4K mediante reescalado neuronal.
El modelo combina acceso programático vía API y Google AI Studio con integración directa en interfaces de postproducción consolidadas como Google Flow, Adobe Firefly y Figma Weave.
El valor competitivo en producción de vídeo con IA se traslada del coste del renderizado y el hardware hacia la solidez conceptual, el guion y el criterio estético del autor.
«El vídeo generativo supera la fase efectista para convertirse en ingeniería de precisión narrativa.»
La generación de vídeo mediante inteligencia artificial ha dependido históricamente de una marcada aleatoriedad en sus resultados. Durante años, los creadores debían introducir descripciones textuales detalladas y confiar en que el modelo interpretara la física del entorno sin distorsionar los rostros ni alterar la iluminación entre tomas consecutivas. El lanzamiento de Gemini Omni 1.1 Flash por parte de Google DeepMind plantea un cambio de paradigma en este sector al priorizar el control directo de cámara, la memoria temporal prolongada y una reducción drástica de los costes computacionales por encima del simple impacto visual.
La evolución técnica de los modelos generativos de vídeo
La historia del vídeo sintético se define por la transición progresiva desde redes neuronales experimentales de baja resolución hasta arquitecturas omnimodales capaces de procesar secuencias continuas. En sus inicios, las redes generativas antagónicas producían fragmentos borrosos de apenas un par de segundos con una resolución diminuta y serias dificultades para interpretar el espacio tridimensional. Con la llegada de los modelos de difusión adaptados al dominio temporal, fue posible sintetizar movimiento fotograma a fotograma en el espacio latente, aunque arrastrando un fenómeno conocido como deriva temporal. Este problema provocaba que el sistema acumulara pequeños errores de cálculo en cada nuevo cuadro generado sobre el anterior, deformando las extremidades y transformando la vestimenta de forma imprevista.
La superación de este cuello de botella ha exigido transformar la propia estructura del modelo. Los sistemas previos operaban mediante cadenas de herramientas desacopladas, donde un modelo de lenguaje interpretaba el texto, una red secundaria generaba los fotogramas y un algoritmo adicional sintetizaba el audio. Por el contrario, la arquitectura omnimodal nativa de Gemini Omni procesa los vectores de texto, imagen y sonido de manera simultánea dentro de un mismo espacio latente. Esta unificación matemática evita pérdidas de información entre capas intermedias y permite que la física visual, la acústica ambiental y la semántica de la escena respondan a una coherencia estructural común.
Arquitectura y novedades técnicas de Gemini Omni 1.1 Flash
Gemini Omni 1.1 Flash es un modelo de generación de vídeo con inteligencia artificial que introduce una ventana de contexto deslizante de diez segundos para garantizar la estabilidad narrativa a lo largo de secuencias de hasta cuarenta segundos. Esta memoria de trabajo funciona como un ancla temporal que frena la degradación del metraje previo, permitiendo al sistema comprender la inercia de los objetos, la dirección de las fuentes de luz y los rasgos fisionómicos de los personajes para encadenar extensiones consecutivas sin cortes abruptos.
Una de sus incorporaciones más relevantes para el flujo de trabajo audiovisual es el control mediante fotogramas clave iniciales y finales. Esta técnica traslada al entorno digital el principio de la animación clásica tradicional, donde un animador principal dibujaba las posturas fundamentales de una escena y el equipo secundario trazaba las ilustraciones intermedias. Con Gemini Omni, el creador define con exactitud la imagen de inicio y la de destino, delegando en el modelo el cálculo de la aceleración, el movimiento de cámara y la física de transición entre ambos puntos. Esta capacidad se ha formalizado en entornos de producción como la herramienta de generación a partir de fotogramas de Google Flow, donde la función de fotograma inicial y final se encuentra habilitada para todas las resoluciones y duraciones, permitiendo ejecutar giros envolventes, efectos de acercamiento compensado o transiciones en bucle continuo con total precisión.
Para garantizar que estas capacidades no queden restringidas al código, el modelo se distribuye a través de múltiples canales de acceso. En el plano del desarrollo de software, los ingenieros pueden interactuar mediante la API de Gemini y Google AI Studio para automatizar flujos de trabajo programáticos o integrar la generación de vídeo en plataformas externas. En el ámbito de las interfaces visuales, herramientas como Google Flow y la propia aplicación de Gemini permiten dirigir escenas mediante lenguaje natural y ajustes directos sin necesidad de programar. Esta versatilidad se completa con la integración nativa en software consolidado de la industria creativa como Adobe Firefly y Figma Weave, admitiendo edición conversacional multi-turno y referencias de vídeo de hasta tres segundos en los flujos habituales de diseño y postproducción.
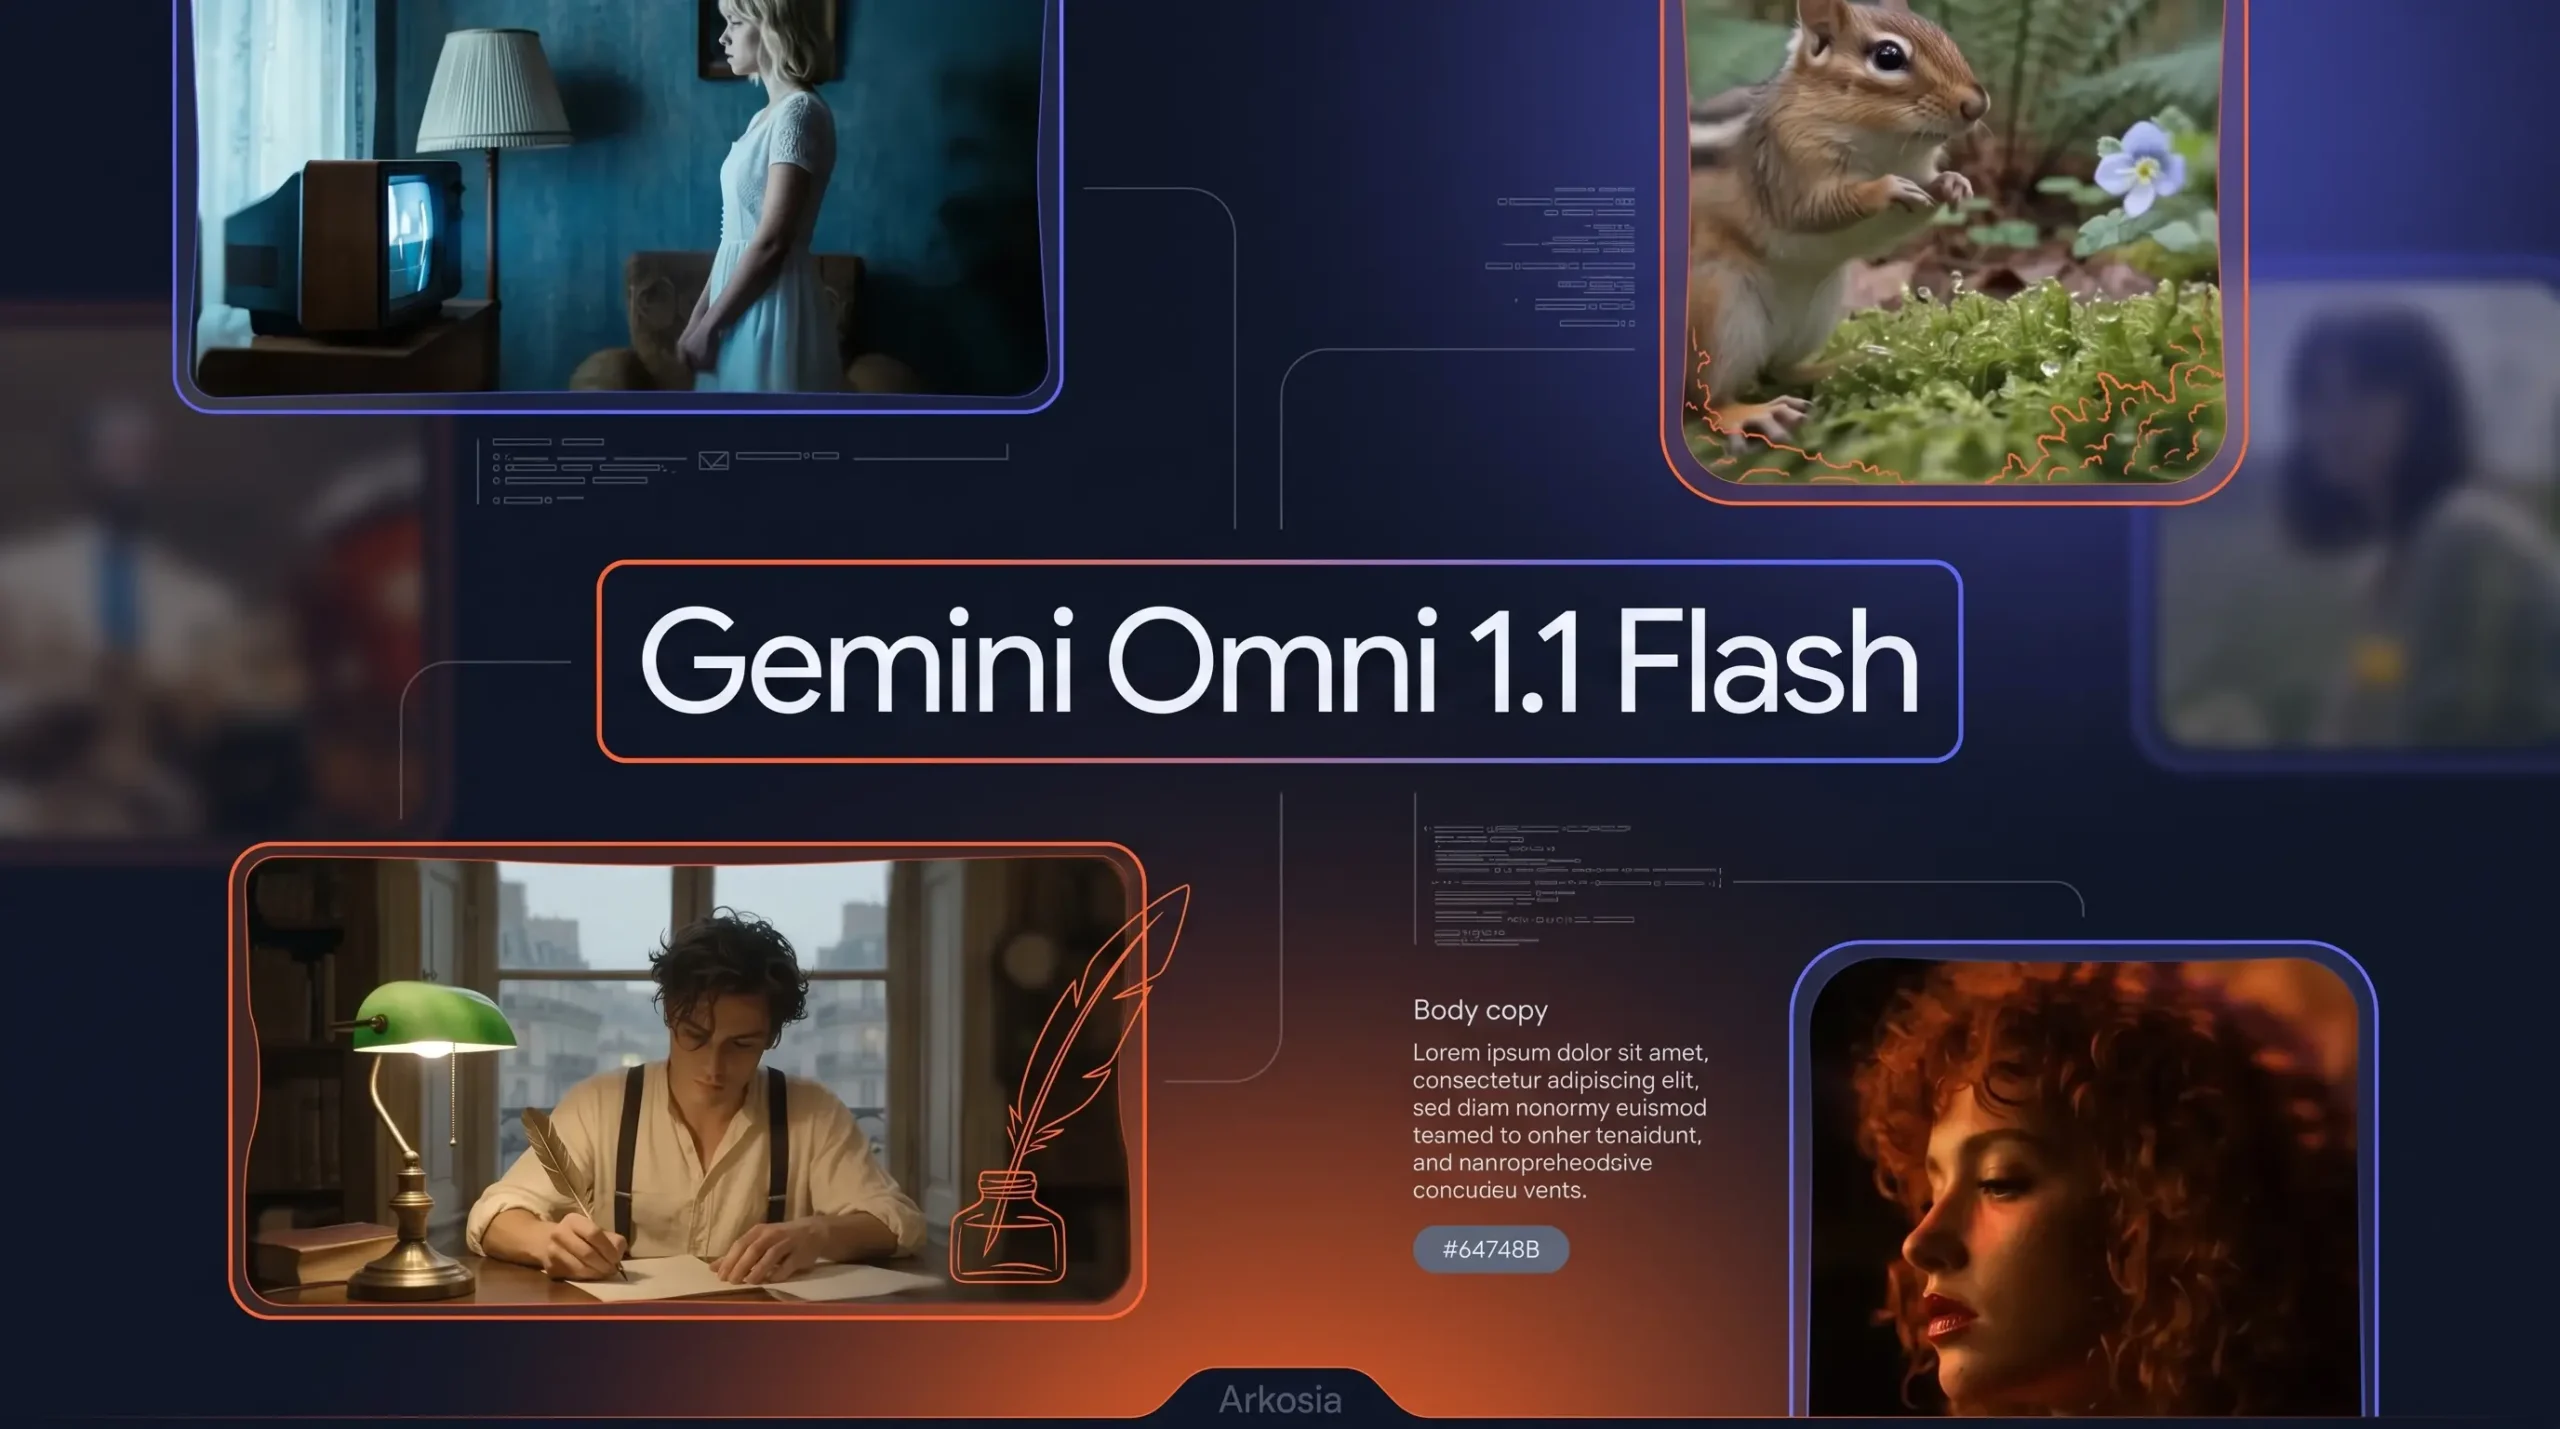
Demostraciones técnicas de Gemini Omni 1.1 Flash
Reducción de costes y eficiencia en el flujo de trabajo
El modo de borrador en 360p de Gemini Omni 1.1 Flash reduce el coste de renderizado a unos tres céntimos de dólar por segundo de metraje, acelerando la velocidad de generación en un sesenta por ciento respecto a los formatos estándar. En interfaces de creación como Google Flow, esta modalidad ligera se ha implementado de forma universal para todos los niveles de usuario, en cualquier duración y modo de generación, reduciendo a la mitad el consumo de créditos frente a una renderización en 720p.
Esta estructura actúa de forma análoga a los bocetos iniciales de un ilustrador o al modelado alámbrico en la animación tridimensional, permitiendo a los creadores validar la composición, el ritmo y los tiros de cámara en storyboards rápidos sin comprometer su saldo de procesamiento. Una vez validada la toma en baja resolución, los usuarios pueden utilizar herramientas integradas de escalado neuronal para transformar directamente sus clips seleccionados a 720p, 1080p o 4K para su acabado profesional. La posibilidad de realizar decenas de pruebas e iteraciones por unos pocos céntimos transforma la viabilidad económica de pequeños estudios y creadores independientes, eliminando el coste asociado a renderizar tomas descartadas en alta definición.
Aplicaciones prácticas en educación, publicidad y cine independiente
La combinación de control milimétrico y costes reducidos habilita casos de uso directos en sectores donde la producción visual tradicional requiere inversiones considerables. En el ámbito de la educación y el material didáctico, la herramienta permite materializar conceptos abstractos en explicaciones dinámicas de alta fidelidad. Un docente puede recrear procesos biológicos a escala celular, ilustrar experimentos de física bajo leyes de movimiento realistas o generar reconstrucciones históricas fidedignas sin depender de metraje de archivo genérico.
En la industria publicitaria y el comercio electrónico, la versatilidad de relaciones de aspecto facilita la generación simultánea de campañas para soportes horizontales convencionales y plataformas de vídeo vertical. Los equipos creativos pueden producir decenas de variantes contextualizadas según la localización geográfica o el momento del día a partir de una única imagen de producto, optimizando el rendimiento de los anuncios con un presupuesto ajustado.
Para la producción audiovisual independiente, el impacto se concentra en las fases de previsualización y efectos visuales. Los directores pueden materializar guiones gráficos animados con fidelidad cinematográfica antes de iniciar el rodaje presencial, lo que permite evaluar el montaje antes de contratar equipo técnico o actores. Del mismo modo, el sistema permite generar planos de apoyo que respetan la iluminación y la paleta cromática de la fotografía principal sin requerir jornadas extraordinarias de grabación.
Flujo de producción por capas con Gemini Omni
Borrador ligero en 360p
Generación de decenas de variantes de plano y tiros de cámara preliminares. Permite descartar y ajustar el ritmo del guion gráfico sin penalizar el cómputo.
Control determinista y keyframes
Fijación de fotogramas clave de inicio y destino. El modelo calcula las físicas y encadena extensiones de 10 segundos preservando la coherencia del personaje.
Reescalado neuronal a 4K
Solo las tomas validadas y montadas pasan al proceso de super-resolución neuronal para acabado profesional en 1080p o 4K con marca de agua SynthID.
Recepción técnica de la comunidad y consideraciones éticas
La comunidad de desarrolladores y creadores profesionales ha valorado de forma positiva la erradicación del componente aleatorio en los personajes y la versatilidad del modelo en entornos visuales y de código. La capacidad de enlazar fotogramas clave y mantener la identidad visual a lo largo de varias tomas resuelve uno de los problemas históricos más frustrantes de la producción con inteligencia artificial.
Sin embargo, los análisis especializados también subrayan los límites que aún deben superarse. La restricción a bloques de cuarenta segundos sigue demandando trabajo de montaje en programas tradicionales para narrativas de mayor duración, y el proceso de escalado a 4K, si bien resulta efectivo en planos generales, puede mostrar pequeñas inconsistencias en texturas de gran complejidad frente a una captura óptica real. En el plano ético y legal, la facilidad para sintetizar imágenes verosímiles refuerza la necesidad de integrar marcas de agua digitales imperceptibles como SynthID para certificar la procedencia del material, al tiempo que acelera el debate sobre la reorganización del trabajo en áreas como la figuración, el doblaje y los catálogos de vídeo de stock.
Un cambio estructural en la creación digital
Gemini Omni 1.1 Flash constata que la inteligencia artificial aplicada al vídeo ha completado su transición desde la fase de demostración efectista hacia la ingeniería de software aplicada a la narrativa. Durante años, la generación sintética de imagen en movimiento se percibió como un truco visual vistoso pero inútil para la producción profesional debido a su falta de control. Al sustituir la aleatoriedad del texto libre por parámetros deterministas como los fotogramas clave, la memoria contextual prolongada y la edición por capas semánticas, la tecnología se alinea por fin con la metodología real de trabajo de directores, montadores y animadores.
Esta evolución altera de raíz la barrera de entrada a la producción audiovisual. Cuando el coste de iteración se reduce a unos pocos céntimos y cualquier creador puede ensayar tiros de cámara, variaciones de iluminación y ritmos de montaje desde una interfaz visual o mediante código, el valor competitivo deja de residir en el capital financiero disponible para alquilar equipos o contratar granjas de renderizado. En este nuevo ecosistema, la ventaja recae íntegramente en la solidez del guion, la precisión conceptual y el criterio estético del creador.
El estándar que fija esta arquitectura omnimodal unificada redefine la relación entre el autor y sus herramientas digitales. La inteligencia artificial no asume el rol del director ni sustituye la visión artística original; asume, en cambio, la ingente carga técnica del cálculo intermedio, la simulación física y el reescalado óptico. Nos adentramos en una etapa donde la complejidad técnica del renderizado queda en un plano secundario y el lenguaje audiovisual recupera el protagonismo absoluto en la creación de contenidos.
Fuentes verificadas
- Anuncio oficial y especificaciones técnicas de Gemini Omni 1.1 Flash
- Documentación técnica del modelo y endpoints de generación de vídeo
- Notas de versión de la API de Gemini: GA, 360p y fotogramas clave
- Investigación y estándares de marcas de agua digital (SynthID)
- Estructura de costes y plataforma para desarrolladores