Los grandes medios y Cloudflare ponen fecha al primer bloqueo masivo contra la inteligencia artificial
Resumen estructurado: El bloqueo masivo contra la IA
El contexto: Tras registrar caídas críticas de tráfico de hasta el 40% causadas por las respuestas generativas de los buscadores, la industria editorial y Cloudflare coordinan una respuesta técnica masiva para cortar el suministro gratuito de datos a los modelos de lenguaje.
Grupos como Dotdash Meredith y Gannett ponen sobre la mesa el bloqueo total a Googlebot y rastreadores de IA ante la ruptura del intercambio tradicional de tráfico por contenido.
Cloudflare automatiza en su WAF la expulsión de rastreadores mixtos y activa el modelo Pay-Per-Crawl, resucitando el estándar HTTP 402 para cobrar micropagos por bloque de datos extraído.
El aislamiento de datos humanos frescos amenaza a los laboratorios tecnológicos con la degeneración matemática y pérdida de coherencia al reentrenar modelos recursivamente con datos sintéticos.
La era de la indexación libre para entrenamiento ha terminado, empujando a los creadores hacia boletines privados, aplicaciones nativas y acuerdos de licencia directa.
«En 2026, la extracción libre de datos ha terminado: o existe compensación técnica por protocolo o se activa el bloqueo en la infraestructura.»
El conflicto económico y técnico entre los creadores de información y los gigantes de la inteligencia artificial ha dejado de ser un debate teórico para convertirse en una confrontación directa con fechas límite muy precisas. A finales de este mes de agosto de 2026, la paciencia de la industria editorial se ha roto definitivamente. Tras registrar desplomes de tráfico orgánico de entre el treinta y cinco y más del cuarenta por ciento debido a las respuestas generativas de los buscadores, los principales grupos de comunicación del mundo y los gigantes de la infraestructura digital han decidido coordinar una respuesta técnica sin precedentes para cortar el suministro gratuito de datos a los modelos de lenguaje.
El nuevo paradigma técnico entre medios e IA
De la extracción indiscriminada de datos a las defensas en capa de red y peajes por protocolo.
Desplome de tráfico orgánico
Las respuestas sintéticas y los agentes autónomos resuelven consultas en milisegundos sin reenviar lectores a las redacciones originales.
Bloqueo WAF en capa de red
Fin de la cortesía pasiva de robots.txt. Cloudflare activa el filtrado automático analizando huella digital y comportamiento de rastreadores mixtos.
Cobro vía protocolo HTTP 402
Sistemas como Pay-Per-Crawl y TollBit establecen pasarelas comerciales obligatorias, cobrando micropagos por bloque de datos consultado por LLMs.
Degeneración por model collapse
Aislar a las tecnológicas del contenido fresco acelera la pérdida de razonamiento cuando los modelos se entrenan recursivamente con datos sintéticos.
El detonante de agosto y la rebelión de los grandes editores internacionales
La mecha definitiva se encendió en las últimas semanas de agosto tras una serie de investigaciones publicadas por cabeceras como The Wall Street Journal y Press Gazette. En estas publicaciones, directivos de primera línea rompieron el habitual tono diplomático para lanzar advertencias directas a Google, OpenAI y Anthropic. Mike Reed, consejero delegado de Gannett, el conglomerado responsable de USA Today y cientos de periódicos locales, y Neil Vogel, máximo responsable de People Inc. y del grupo Dotdash Meredith, confirmaron públicamente que la opción de bloquear por completo a los rastreadores de búsqueda está cien por cien sobre la mesa.
El motivo de este ultimátum es puramente económico. Durante más de dos décadas, los medios ofrecieron su trabajo de forma abierta a cambio de que los enlaces de Google derivaran millones de lectores a sus páginas, sosteniendo así las redacciones mediante publicidad y suscripciones. Sin embargo, las respuestas sintéticas inmediatas y los agentes de búsqueda autónoma como SearchGPT o Perplexity procesan las noticias en milisegundos mediante técnicas de recuperación en tiempo real, ofreciendo la información terminada sin enviar un solo clic a la fuente original. Para los editores, mantener servidores caros y periodistas en nómina para que las tecnológicas moneticen sus resúmenes se ha vuelto insostenible.
El fin del pacto de caballeros y las nuevas defensas activas de Cloudflare
Esta crisis ha dejado al descubierto las limitaciones de los sistemas tradicionales de control de acceso. Durante décadas, la relación entre páginas web y buscadores se gestionó mediante el archivo de texto robots, una directiva que nunca fue una barrera de seguridad real, sino un pacto voluntario entre caballeros. En los últimos años, muchos rastreadores automatizados y agentes de inteligencia artificial aprendieron a ignorar este archivo o a camuflarse utilizando granjas de servidores intermedios para simular que eran usuarios humanos navegando con normalidad.
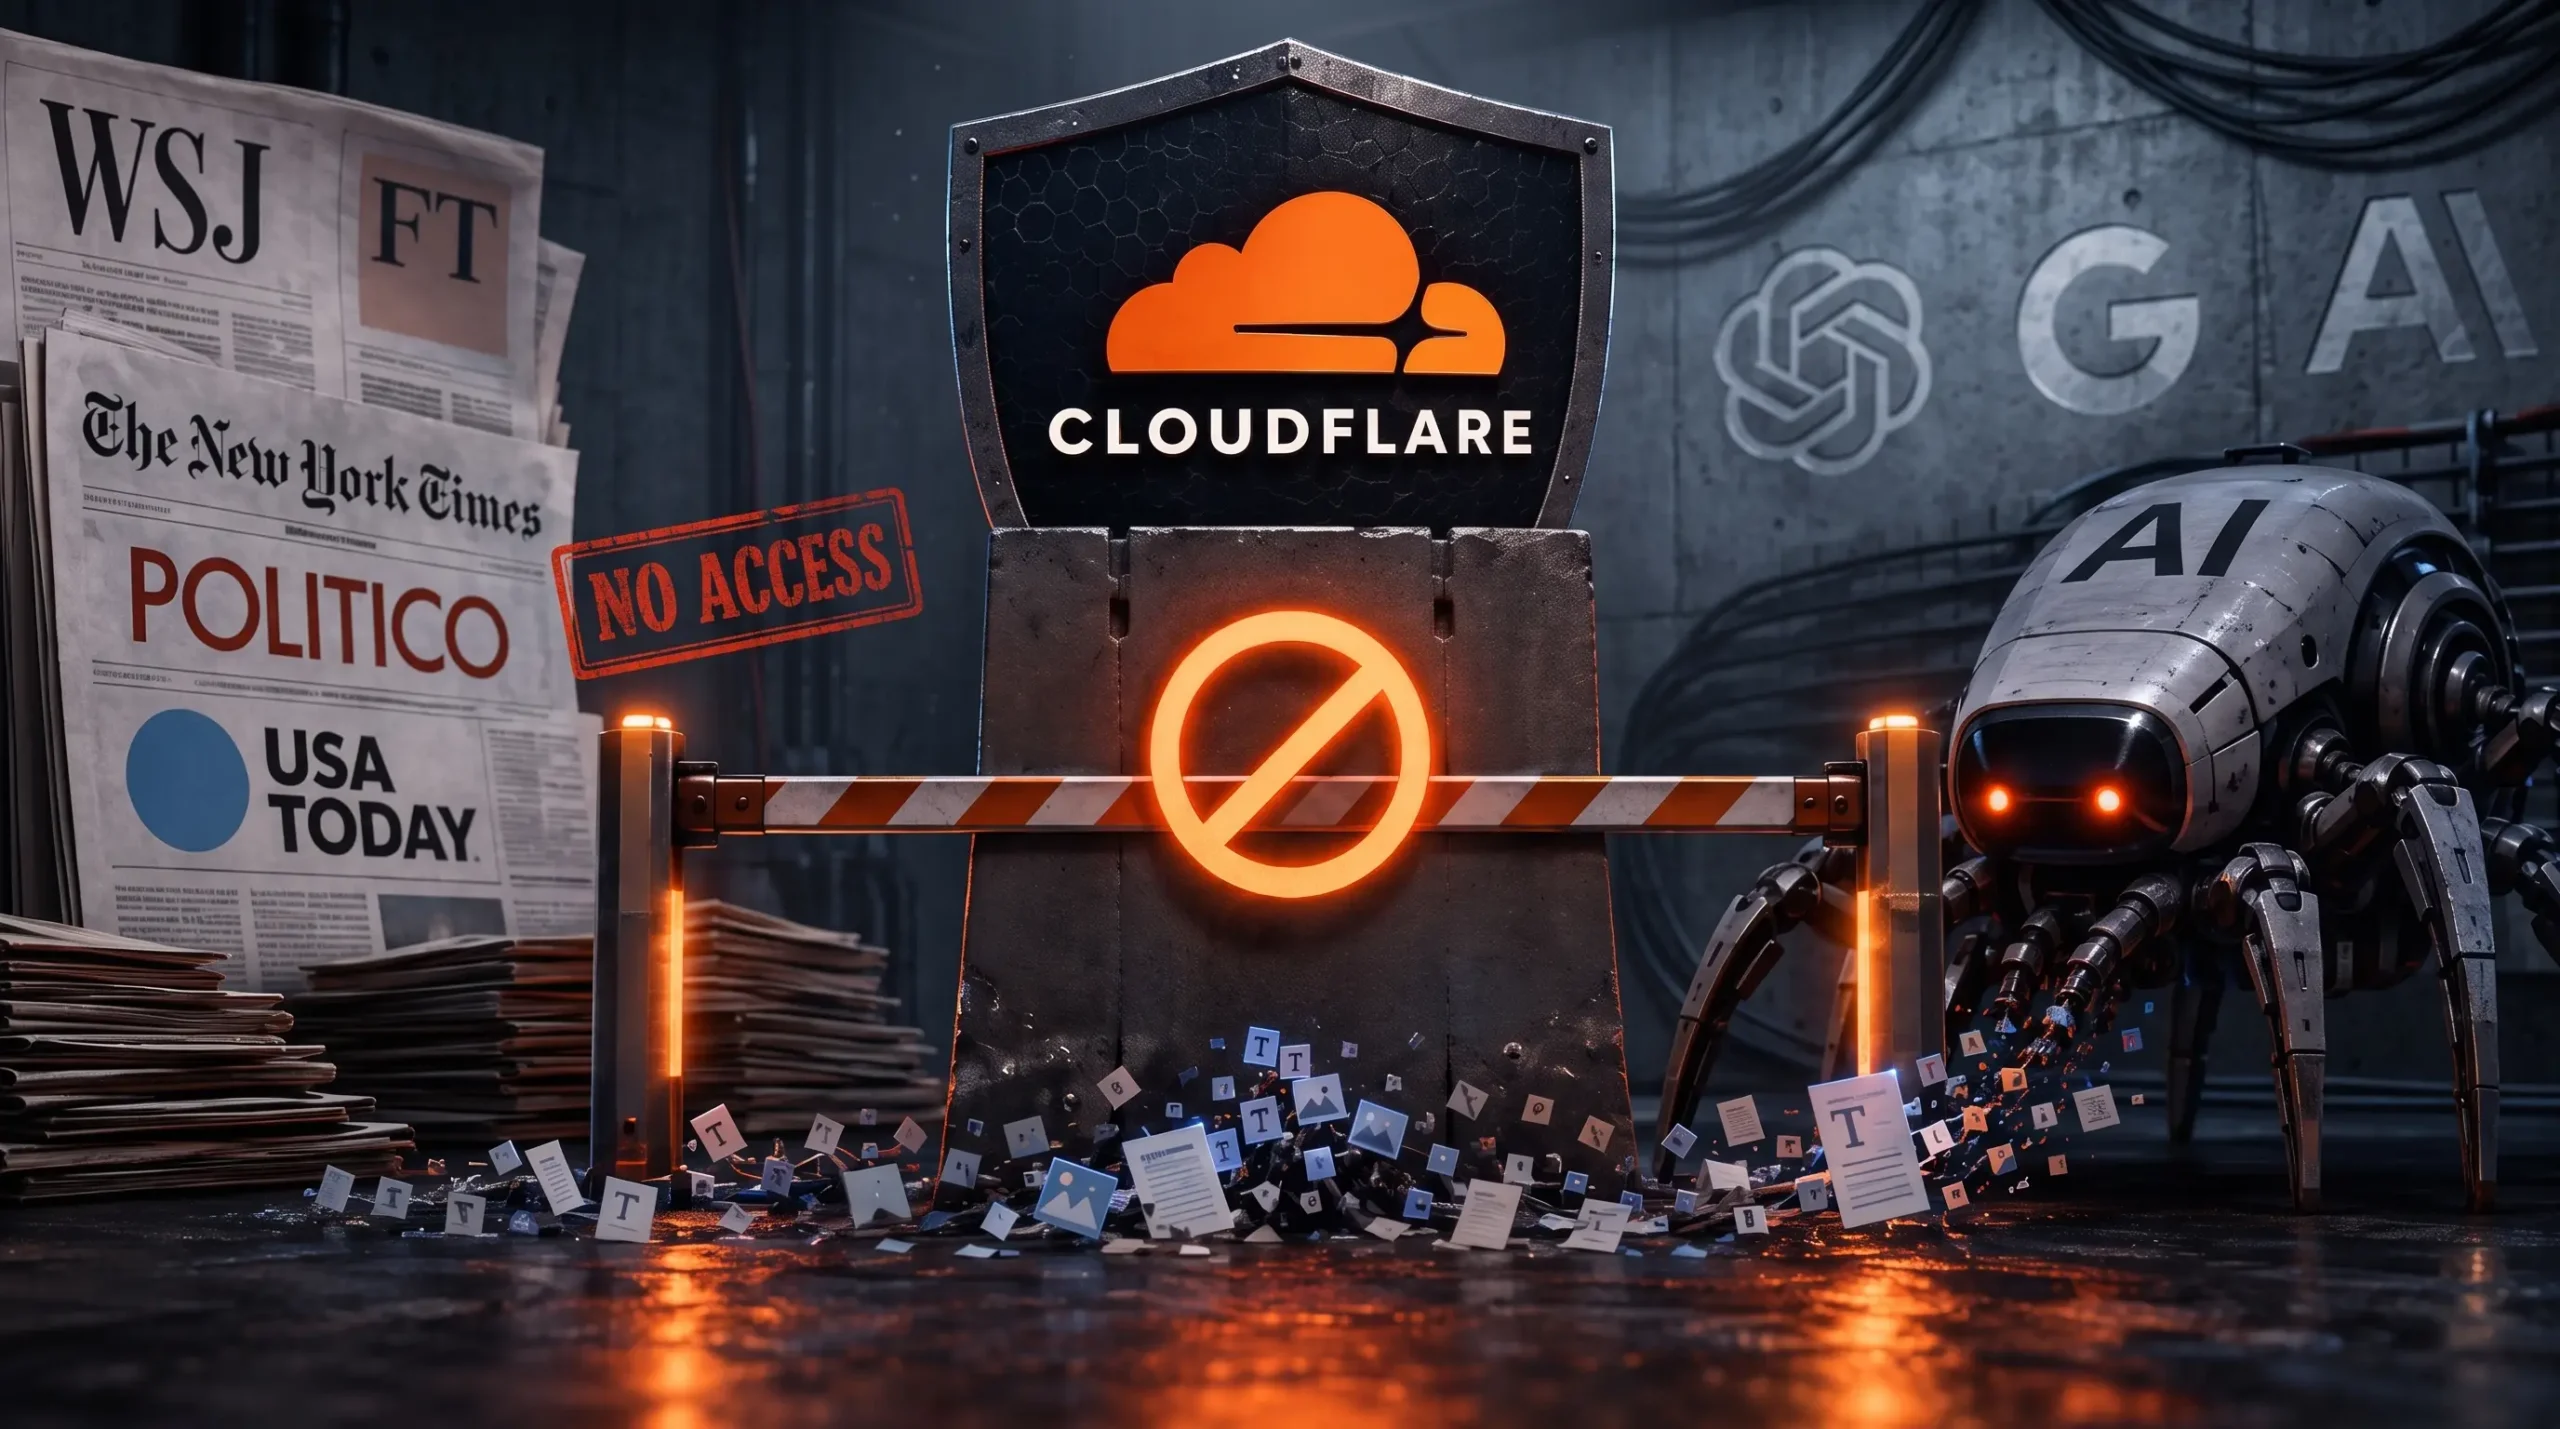
La respuesta contundente ha llegado de la mano de Cloudflare, la plataforma de red que protege y gestiona cerca del veinte por ciento de todo el tráfico de internet, que ha fijado el quince de septiembre de 2026 como una fecha decisiva. A partir de ese día, la compañía activará en sus cortafuegos el bloqueo automático y por defecto de todos los rastreadores de propósito mixto. La novedad técnica no consiste en pedir permiso por escrito, sino en analizar la huella digital y el comportamiento de la conexión para detectar y expulsar al instante a cualquier programa automatizado que intente extraer datos sin autorización, impidiendo que las tecnológicas sigan utilizando los mismos robots para indexar páginas y entrenar sus modelos.
Del intercambio de tráfico al peaje por protocolo
Evolución del acceso web y monetización de contenidos frente al entrenamiento de inteligencia artificial.
La web abierta y el pacto de caballeros
-
Control pasivo con robots.txt Directivas voluntarias sin validación criptográfica ni consecuencias ante el rastreo masivo.
-
Retorno en tráfico orgánico Indexación gratuita a cambio de derivación masiva de visitas, publicidad y altas de suscripción.
-
Extracción abierta y sin coste Scraping libre utilizado para entrenar modelos sin compensación técnica ni económica a los creadores.
Defensas activas y tarificación HTTP 402
-
Bloqueo WAF en capa de red Filtrado automático por análisis de huella digital y expulsión en tiempo real de bots mixtos.
-
Pay-Per-Crawl y pasarelas de pago Exigencia de micropagos estructurados por bloque de texto mediante cabeceras estándar HTTP 402.
-
Entornos cerrados y acuerdos directos Migración hacia canales protegidos, boletines privados y licencias exclusivas para mitigar el colapso del modelo.
Peajes por protocolo y el dilema de los acuerdos exclusivos
El objetivo final de esta ofensiva no es apagar internet, sino establecer un modelo comercial obligatorio. Para lograrlo, plataformas de intermediación como TollBit y el nuevo sistema Pay-Per-Crawl de Cloudflare están resucitando el código HTTP 402, un estándar diseñado en los orígenes de la web para indicar que un recurso requiere un pago para ser consultado. Bajo este nuevo esquema, si una compañía de inteligencia artificial necesita consultar una noticia reciente para evitar que su modelo alucine, el servidor exigirá automáticamente un micropago por cada bloque de texto o paquete de datos consumido.
Sin embargo, esta transición ha abierto una profunda fractura en la propia industria de los medios. Mientras grupos como Gannett o Politico amenazan con el apagón total, gigantes editoriales como Axel Springer, News Corp o Financial Times ya han firmado acuerdos millonarios y exclusivos con OpenAI o Google para vender su contenido de forma directa. Este escenario genera un peligroso dilema en el sector, ya que amenaza con crear un cártel informativo cerrado donde un puñado de grandes corporaciones monopoliza las respuestas de la inteligencia artificial, dejando a los medios medianos e independientes sin tráfico y sin compensación económica.
El temor de los pequeños creadores y la trampa del colapso del modelo
Este movimiento ha desatado un debate de enorme intensidad en foros técnicos como Reddit, Hacker News y comunidades de desarrolladores web. Aunque una gran parte de los administradores celebra que por fin se ponga un freno a la extracción desmedida de recursos, existe una preocupación justificada entre los creadores independientes. Los proyectos modestos y los blogs especializados temen quedarse en tierra de nadie, sin la capacidad de negociar acuerdos multimillonarios con las tecnológicas y desprovistos del tráfico que antes les garantizaba el buscador.
Al mismo tiempo, la industria de la inteligencia artificial se enfrenta a una amenaza estructural conocida en ingeniería como el colapso del modelo. Si los laboratorios de inteligencia artificial quedan aislados del contenido humano fresco y comienzan a entrenar sus futuros sistemas utilizando textos generados previamente por otras máquinas, los modelos degeneran con rapidez y pierden su capacidad de razonamiento. Bloquear a la inteligencia artificial no es solo un problema para los medios que pierden visibilidad, sino un golpe crítico para las propias empresas tecnológicas, cuya supervivencia técnica depende obligatoriamente de seguir consumiendo información humana de alta calidad.
La retirada hacia jardines vallados y el futuro de la red
Ante la incertidumbre de este nuevo panorama, los medios de comunicación han comenzado una retirada estratégica hacia entornos cerrados y directos donde los rastreadores de inteligencia artificial no pueden penetrar. La aceleración de las aplicaciones móviles nativas, el auge de los boletines privados por correo electrónico, las comunidades de pago y los formatos en audio y vídeo buscan reconstruir una relación directa con el lector al margen de los buscadores.
El equilibrio que sostuvo a internet durante un cuarto de siglo ha llegado a su fin. En este cierre de agosto de 2026, la industria de la comunicación y los ingenieros de servidores han dejado claro que la era de la información gratuita para alimentar inteligencias artificiales ha terminado. Las decisiones técnicas y comerciales que se tomen a partir del quince de septiembre marcarán si caminamos hacia una red fragmentada y de pago o hacia un nuevo estándar donde creadores y máquinas puedan convivir de forma sostenible.
Fuentes verificadas
- People Inc not blocking Google ‘at the moment’ as it rolls out digital subscriptions
- Cloudflare says bot blocking is fuelling publisher AI deals
- Declara tu independencia de la IA: evita los bots de IA, de apropiación de contenido y de rastreo web con un solo clic
- Introducing pay per crawl: Enabling content owners to charge AI crawlers for access
- TollBit: Mercado de contenidos y licencias en tiempo real para agentes de IA
- AI models collapse when trained on recursively generated data