La ventaja de EE. UU. en IA cae al 3% frente a China tras el avance de DeepSeek
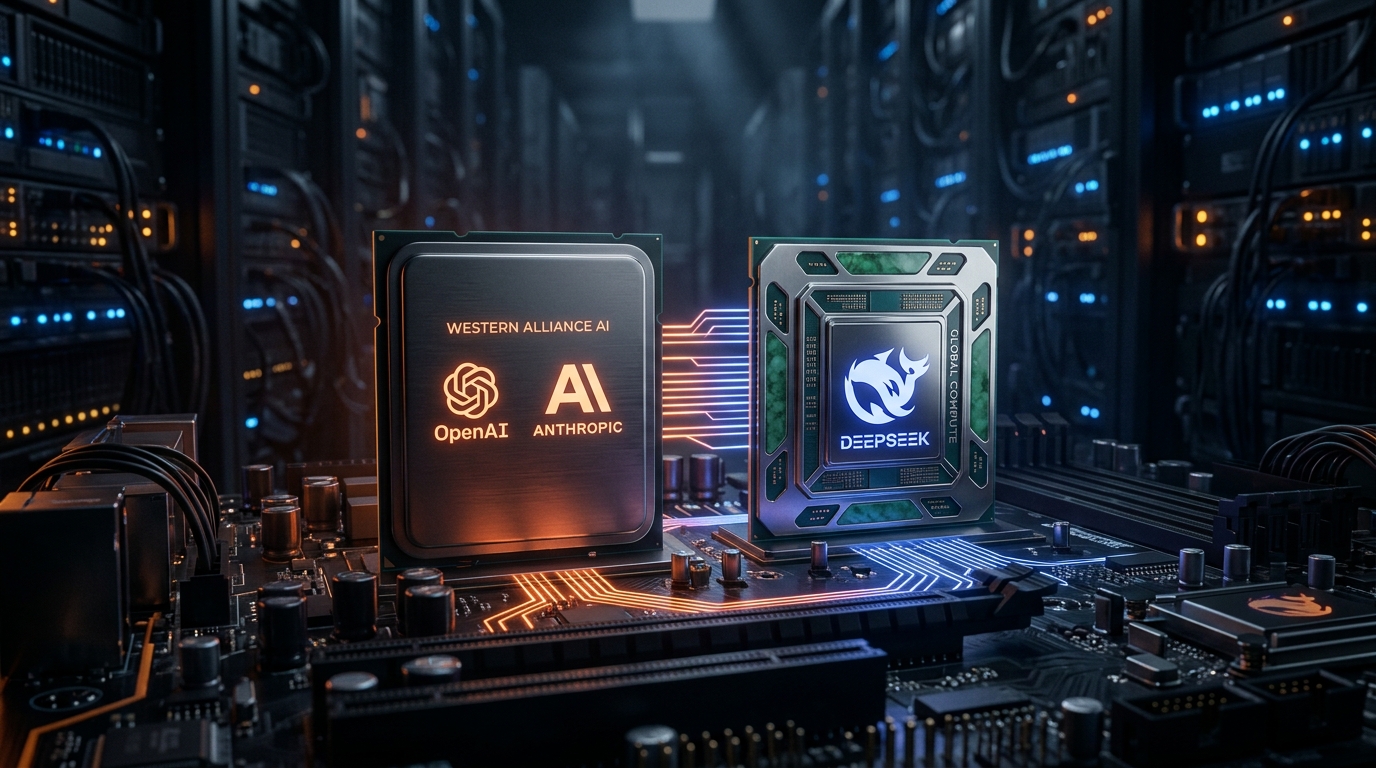
El contexto: Un informe de Bloomberg Intelligence certifica que la distancia de rendimiento entre los modelos frontera de Estados Unidos y China se ha reducido al mínimo histórico del 3 % tras el lanzamiento de DeepSeek V4.1 Flash.
La ventaja estadounidense en el benchmark LiveBench cayó del 15 % a principios de 2026 y del 9 % en mayo a solo un 3 % en octubre, con DeepSeek (81,1 puntos) rozando el techo de Anthropic (83,4).
El bloqueo de exportación de silicio puntero no ha frenado el avance chino; los laboratorios asiáticos han respondido con co-diseño algorítmico, arquitecturas MoE avanzadas y optimización extrema para silicio nativo.
Mientras DeepSeek supera a los referentes occidentales en programación agéntica (77,3 frente a 66,1), la hipercompetencia interna china con más de 1.100 modelos amenaza la rentabilidad comercial del sector hasta 2030.
«El foso defensivo basado en acaparar clusters masivos de GPUs se ha evaporado: la eficiencia algorítmica ha demostrado que se puede alcanzar la frontera tecnológica con una fracción del hardware.»
El fin de la hegemonía indiscutida: una brecha reducida al margen de error
Durante los últimos tres años, el relato hegemónico de Silicon Valley descansó sobre un axioma aparentemente inexpugnable: quien posee las mayores granjas de cómputo, el acceso exclusivo a los chips de litografía más avanzada y la capacidad de financiar rondas multimillonarias mantendría una ventaja tecnológica de al menos dos años frente a cualquier competidor global. Las restricciones a la exportación de aceleradores de última generación dictadas por Washington formaban parte de esa doctrina de contención. Sin embargo, los datos empíricos acaban de dinamitar ese consenso. Un exhaustivo informe publicado por Bloomberg Intelligence revela que la distancia real de rendimiento entre los mejores sistemas de inteligencia artificial estadounidenses y sus equivalentes chinos se ha desplomado hasta un raquítico 3 %.
La trayectoria de esta convergencia es vertiginosa. Según los análisis del analista sénior Robert Lea para Bloomberg Intelligence, la brecha de rendimiento en evaluaciones estandarizadas se situaba en torno al 15 % a comienzos de 2026 y descendía al 9 % el pasado mes de mayo. La publicación y despliegue del modelo DeepSeek V4.1 Flash ha terminado por comprimir esa diferencia a apenas 2,3 puntos en la tabla global de LiveBench: el sistema de DeepSeek alcanzó los 81,1 puntos, pisándole los talones a la mejor marca de Anthropic, fijada en 83,4 puntos. Para un ingeniero de producto o un director de tecnología, una variación del 3 % no constituye una brecha generacional; representa, a efectos prácticos de despliegue industrial, paridad operativa.
La erosión de la prima de precio en Silicon Valley
Este estrechamiento de capacidades tiene consecuencias inmediatas sobre la economía del software. Los proveedores occidentales habían fundamentado sus agresivos precios por millón de tokens en la promesa de un foso defensivo inalcanzable. Se asumía que pagar tarifas elevadas por modelos propietarios en la nube garantizaba un nivel de razonamiento cualitativamente superior al de cualquier alternativa abierta o foránea. Esa narrativa se ha vuelto extraordinariamente difícil de sostener. Cuando un equipo de desarrollo comprueba que en las pruebas específicas de programación agéntica (agentic coding) el modelo chino no solo no va a la zaga, sino que toma la delantera con 77,3 puntos frente a los 66,1 puntos registrados por la vanguardia estadounidense, la justificación de un monopolio de precios se desmorona por completo.
Para entender el impacto cotidiano de este giro, imaginemos la industria automotriz de alta competición. Silicon Valley apostó por construir motores colosales con turbocompresores gigantescos que devoran cantidades ingentes de combustible de alto octanaje, confiando en que nadie más podría pagar semejante factura energética. Paralelamente, los investigadores de DeepSeek rediseñaron la aerodinámica del chasis, aligeraron cada pieza del motor y lograron que un propulsor estándar rinda a la misma velocidad en pista. Cuando la eficiencia matemática iguala la fuerza bruta del hardware, las reglas del juego cambian para todos los que consumen esa tecnología.
Comparativa de Rendimiento y Arquitectura en la Vanguardia de la IA
Métricas de LiveBench y estructura de cómputo entre modelos líderes según Bloomberg Intelligence
| Dimensión Analítica |
DeepSeek V4.1 Flash
|
Líder Anthropic (Claude)
|
Referente OpenAI (GPT)
|
|---|---|---|---|
|
Puntuación Global LiveBench
Capacidad agregada de razonamiento y tareas complejas
|
81,1 puntos (6º puesto mundial) | 83,4 puntos (1º puesto mundial) | 82,8 puntos (Posición frontera) |
|
Programación Agéntica
Sub-benchmark de resolución y refactorización de código
|
77,3 puntos (Líder destacado) | 66,1 puntos | 69,4 puntos |
|
Arquitectura Subyacente
Esquema de activación y gestión de contexto
|
MoE ultradisperso + MLA | Denso / MoE híbrido propietario | MoE propietario multi-etapa |
|
Dependencia de Hardware
Adaptación ante restricciones de semiconductores
|
Optimizado para silicio doméstico / kernels a medida | Altamente dependiente de clusters Nvidia de vanguardia | Dependencia masiva de infraestructura hyperscaler |
|
Presión de Coste por Token
Estructura de precios para integración en producción
|
Coste hiperreducido / comoditizado | Tarifa premium empresarial | Tarifa de margen comercial medio-alto |
Bajo el capó de DeepSeek: la victoria del co-diseño algorítmico
¿Cómo ha logrado un laboratorio independiente desafiar el bloqueo de silicio y acortar la distancia frente a corporaciones con presupuestos casi ilimitados? La respuesta no reside en el contrabando de chips ni en la magia negra, sino en una reingeniería profunda de los cuellos de botella de la arquitectura Transformer. Mientras los laboratorios de referencia occidentales continuaban escalando modelos densos o confiando en agrupaciones brutales de memoria de alto ancho de banda (HBM), DeepSeek perfeccionó dos palancas complementarias: la arquitectura de Mezcla de Expertos (Mixture of Experts, MoE) y la atención latente multicabezal (Multi-head Latent Attention, MLA).
Para visualizar cómo funciona la atención latente multicabezal, pensemos en la memoria de trabajo de una reunión ejecutiva. En un Transformer tradicional, cada palabra que el usuario escribe obliga al sistema a almacenar en memoria rápida (la caché de Claves y Valores o KV cache) un expediente completo de relaciones sintácticas y contextuales. A medida que la conversación se alarga, esa libreta de notas engorda tanto que satura la memoria física de la GPU, provocando latencia y costes disparados. La técnica MLA comprime radicalmente esas representaciones latentes en un espacio de dimensiones reducidas antes de archivarlas, descomprimiéndolas únicamente en el milisegundo exacto en que se calculan las cabezas de atención. El resultado práctico es una reducción de hasta el 80 % en el consumo de memoria rápida por token, permitiendo procesar ventanas de contexto kilométricas sin ahogar el silicio.
Especialización quirúrgica frente a asambleas masivas
La segunda pieza clave del engranaje es la topología de activación dispersa. En lugar de movilizar los cientos de miles de millones de parámetros que integran el modelo ante cada palabra que entra por el prompt —el equivalente a convocar a todos los cirujanos, anestesistas y celadores de un hospital para medirle la tensión a un paciente—, la arquitectura MoE de DeepSeek delega la tarea exclusivamente en micro-redes expertas minuciosamente orquestadas. Esta modularidad extrema reduce drásticamente el coste computacional por inferencia (FLOPs por token), logrando que un modelo catalogado como «Flash» entregue respuestas de nivel frontera con una latencia propia de modelos ligeros de destilación.
A esto se suma el co-diseño de bajo nivel adaptado a silicio heterogéneo. Privados del acceso irrestricto a los clústeres Nvidia de última hornada, los ingenieros chinos han reescrito los kernels de computación a medida para exprimir procesadores domésticos (como las familias Ascend) y topologías de red optimizadas para lidiar con anchos de banda inferiores. La restricción material actuó como un acelerador darwiniano: obligó a eliminar cualquier ineficiencia en el código de entrenamiento y en las fases de aprendizaje por refuerzo con razonamiento paso a paso, demostrando que la optimización a nivel de hardware local puede compensar la desventaja en especificaciones brutas.
Dilema de Despliegue: Modelos Chinos Eficientes vs. Plataformas Cerradas de EE. UU.
Ventajas y Eficiencia
- Optimización de tiempos de iteración técnica
- Conformidad con marcos regulatorios comunitarios
- Capacidad de inferencia escalable en producción
Fricciones y Costes
- Optimización de tiempos de iteración técnica
- Conformidad con marcos regulatorios comunitarios
- Capacidad de inferencia escalable en producción
La arquitectura es viable en producción siempre que se mantenga un cortafuegos determinista para limitar el coste marginal.
Implicaciones estratégicas para CTOs: diversificación y guerra de márgenes
La fotografía descrita por Bloomberg Intelligence no deja espacio para la complacencia en los departamentos de ingeniería. Para los arquitectos de software y líderes técnicos, el imperativo inmediato pasa por desmontar cualquier arquitectura cautiva (vendor lock-in) ligada a una única API propietaria estadounidense. Si la brecha entre el modelo más exclusivo de San Francisco y una alternativa accesible es de apenas un 3 % en tareas generales, y favorable a esta última en desarrollo de software, mantener integraciones rígidas equivale a aceptar un lastre financiero innecesario. La tendencia ineludible para los próximos trimestres es el enrutamiento dinámico de modelos (model routing), donde las cargas de trabajo cotidianas se arbitran en función del coste por token y la latencia, reservando los modelos cerrados más caros exclusivamente para casos de borde estadísticamente residuales.
No obstante, el escenario no está exento de fricciones de calado. El informe de Bloomberg subraya una paradoja inquietante: a pesar de su brillantez técnica, el ecosistema de inteligencia artificial en China afronta una crisis estructural de rentabilidad comercial. Con más de 1.100 modelos de lenguaje censados compitiendo salvajemente en el mercado doméstico y tarifas de inferencia empujadas hacia el suelo por una guerra de precios descarnada, los analistas de Bloomberg Intelligence prevén que el sector difícilmente alcanzará la rentabilidad operativa antes de 2030. Con la excepción de productos específicos orientados a consumo masivo como Doubao de ByteDance, gran parte de los chatbots de vanguardia continúan ofreciéndose a pérdidas o de forma gratuita, dependiendo del respaldo financiero de conglomerados industriales y rondas multimillonarias como la negociada actualmente por DeepSeek junto a gigantes como Tencent y CATL.
Soberanía tecnológica, gobernanza y el horizonte de 2026
Al desafío de la sostenibilidad económica se añade el laberinto del cumplimiento normativo y la geopolítica. Para las organizaciones que operan bajo el marco regulatorio europeo del AI Act o estándares estrictos de ciberseguridad corporativa, la adopción de modelos entrenados o alojados bajo jurisdicciones asiáticas exige auditorías reforzadas en materia de privacidad, residencia de datos y mitigación de sesgos algorítmicos. La respuesta más pragmática para la industria no radica necesariamente en consumir APIs alojadas en servidores remotos, sino en aprovechar la disponibilidad de modelos con pesos abiertos o semilocales, desplegados en entornos de nube privada o infraestructura soberana dentro de la Unión Europea.
En conclusión, el salto cualitativo de DeepSeek V4.1 Flash marca un punto de no retorno en la historia de la inteligencia artificial. La creencia de que Occidente disfrutaba de una ventaja inexpugnable blindada por restricciones comerciales ha quedado formalmente refutada. Para la comunidad técnica, este nuevo equilibrio es una excelente noticia: dinamita el riesgo de un oligopolio de infraestructura, presiona las tarifas de cómputo a la baja y demuestra que la inteligencia artificial del futuro no se ganará levantando centros de datos cada vez más faraónicos, sino perfeccionando la elegancia y la eficiencia de la ingeniería del software.