AMD Helion redefine la infraestructura de centros de datos para agentes
El contexto: AMD Helion introduce una especificación de bastidor abierto en OCP que independiza el cómputo lógico de agentes respecto a los aceleradores de inferencia.
El bastidor aloja hasta 32.768 núcleos Zen 6 en configuraciones exclusivas de CPU para ejecución general.
Un enrutador integrado distribuye las consultas del agente entre pesos abiertos locales y modelos de frontera.
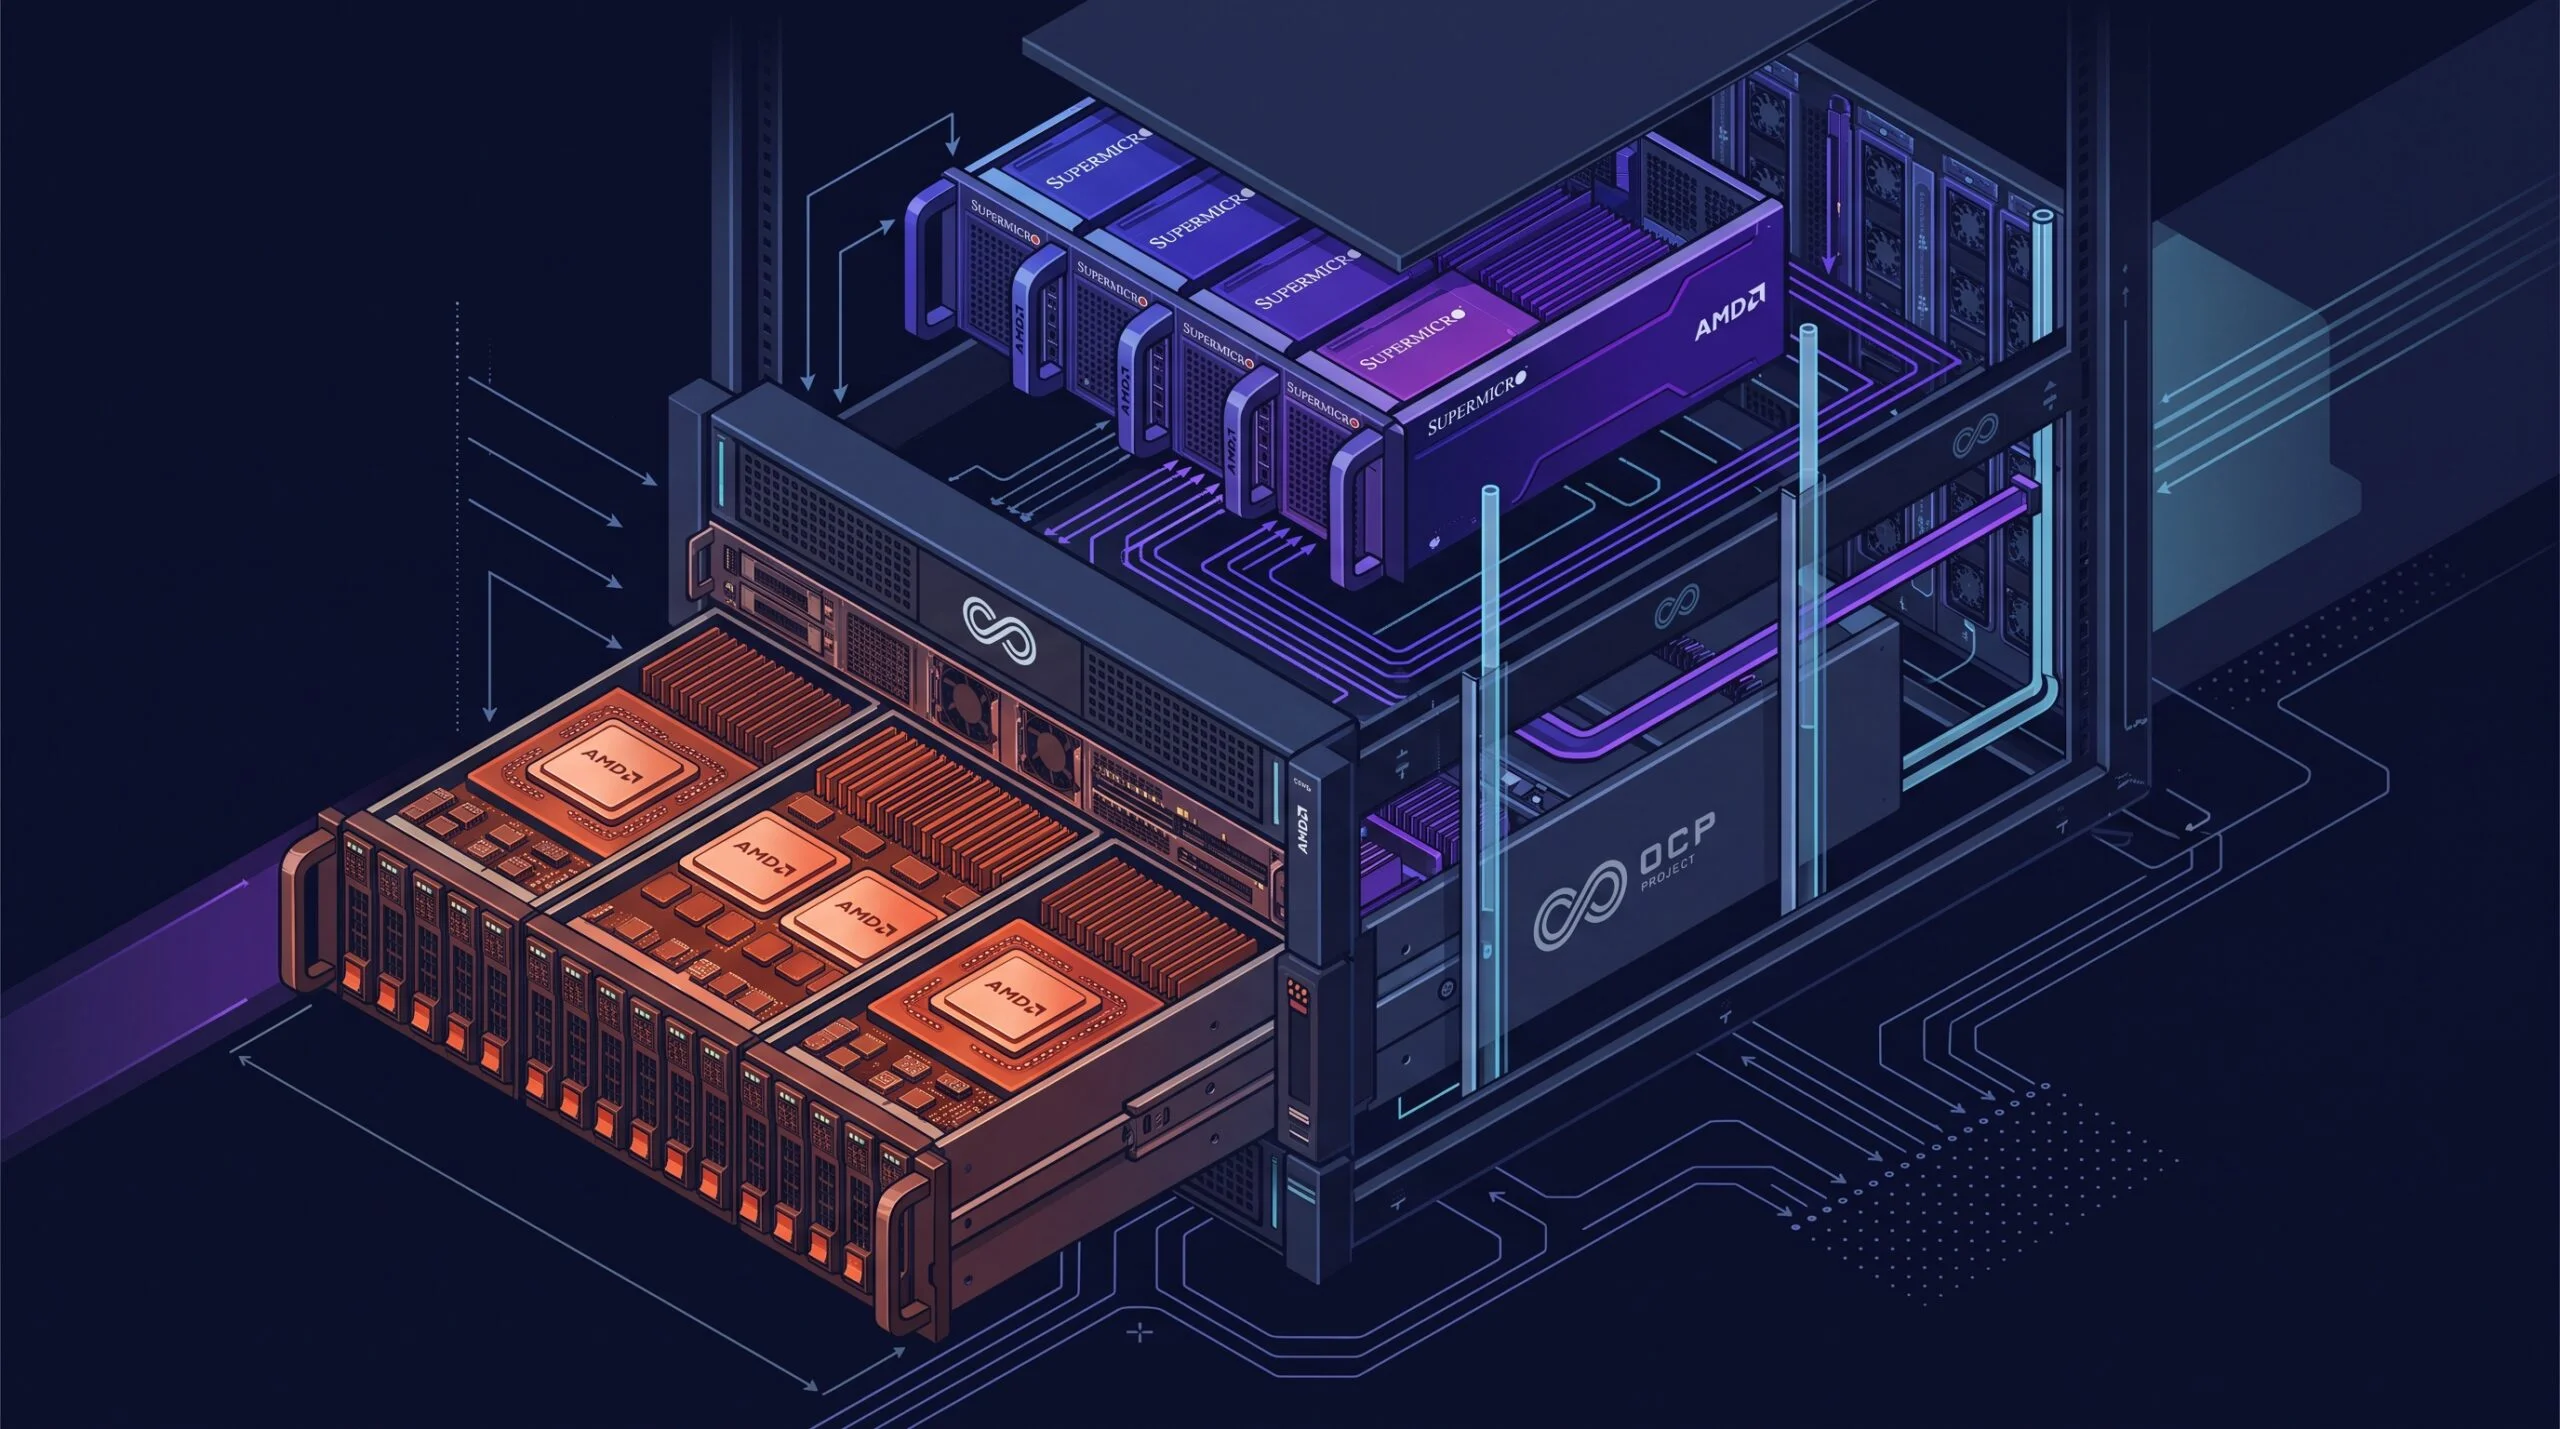
La especificación permite combinar nodos EPYC con aceleradores Instinct MI350P bajo refrigeración líquida directa.
«La orquestación de flujos agenticos exige ciclos deterministas de CPU que asfixian los clústeres exclusivos de GPU.»
La ejecución de sistemas autónomos multiagente ha colisionado contra la topología física tradicional de los centros de datos de inteligencia artificial. Durante los últimos tres años, la industria concentró su capital en bastidores dominados casi exclusivamente por aceleradores matriciales conectados por tejidos propietarios, asumiendo que cualquier carga de trabajo emergente se resolvería incrementando los gigavatios dedicados al procesamiento de pesos. Sin embargo, la operación real de agentes en entornos corporativos muestra un perfil asimétrico: el tiempo de ejecución se diluye entre llamadas a APIs externas, parseo de árboles sintácticos, sandboxes de código Python, sincronización de memoria de contexto y gestión de estados distribuidos. Asignar estas tareas secuenciales a clústeres de 100.000 dólares por nodo desperdicia ciclos de cómputo de coma flotante y satura los enlaces de red inter-GPU.
AMD ha respondido a esta distorsión arquitectónica en la cumbre OCP Global Summit 2026 presentando Helion. Se trata de una especificación de bastidor abierto concebida bajo las directrices del Open Compute Project (OCP) que desagrega formalmente la capa de control y ejecución de agentes de la capa de inferencia pura. El diseño de referencia permite alcanzar densidades de hasta 32.768 núcleos de procesamiento central en un solo rack mediante procesadores AMD EPYC de sexta generación con microarquitectura Zen 6. El movimiento traslada la batalla de la infraestructura desde el silicio monolítico hacia la orquestación modular de sistemas completos a escala de centro de datos.
Por qué el cómputo agentico fractura las arquitecturas GPU monolíticas
«El cómputo agentico no es una carga de trabajo única. Abarca agentes personales, aplicaciones corporativas, ejecución de código y flujos de trabajo complejos, cada uno con requisitos de cómputo dispares», ha señalado Dan McNamara, vicepresidente sénior y director general de Cómputo e IA Corporativa en AMD. La disonancia entre la naturaleza de los modelos de lenguaje y la de los agentes radica en el factor de concurrencia y la predictibilidad del flujo de instrucciones. Mientras la inferencia densa optimiza operaciones tensoriales masivas en paralelo, el ciclo de vida de un agente depende de bucles de razonamiento (como ReAct o Plan-and-Solve) donde el 70% del tiempo acumulado corresponde a latencia de red, lectura de bases vectoriales y compilación de scripts en aislamiento de seguridad.
Al alojar estas rutinas en infraestructuras concebidas para entrenamiento o servicio masivo de tokens, los operadores sufren una degradación severa del factor de utilización de la GPU. La especificación Helion ataca este desperdicio habilitando fabricantes como Cisco, Dell Technologies, Supermicro, HPE y Lenovo para construir chasis donde la potencia térmica y el ancho de banda se calibran específicamente según la fase del pipeline de inferencia y ejecución. La estandarización abierta sobre el chasis Open Rack (ORv3/ORv4) de 21 pulgadas garantiza que los despliegues no dependan de gabinetes cerrados ni de sistemas propietarios de distribución de energía en corriente continua.
Topología Monolítica frente a Desacoplamiento Helion
Comparativa de asignación de recursos y eficiencia en cargas agenticas
Bastidor Tradicional GPU-Centric
- Ciclos matriciales caros desperdiciados en parsing de texto y sandboxes.
- Consumo excesivo de memoria HBM para retener estados latentes.
- Sobrecarga de interrupciones del kernel que degrada la inferencia continua.
Bastidor Desacoplado AMD Helion
- Hasta 32.768 núcleos Zen 6 dedicados al control y bucles de decisión.
- Enrutador de tokens inteligente entre modelos locales y de frontera.
- Inferencia acelerada preservada exclusivamente para cálculo FP4/FP8.
La especificación Helion se estructura en torno a dos variantes físicas orientadas a resolver tipologías de demanda divergentes. La primera variante, enfocada a proveedores de nube a hiperescala, elimina por completo los aceleradores gráficos del gabinete. Aloja hasta 128 procesadores EPYC de alta densidad, totalizando 32.768 núcleos Zen 6 en 44 bandejas modulares OpenU. Este bastidor opera como un clúster dedicado exclusivamente a la orquestación lógica, la gestión de colas de mensajes y el mantenimiento de las memorias episódicas de millones de agentes concurrentes, vinculándose a través de redes Ethernet RDMA (RoCEv2) de ultra baja latencia con clústeres externos de aceleración densa.
La división física entre ejecución secuencial y aceleración matricial
Esta segregación física permite aislar entornos de ejecución hostiles. Cuando un agente genera código interpretado para validar una consulta SQL o transformar un conjunto de datos, esa instrucción debe correr en un microcontenedor con límites de seguridad estrictos. Ejecutar miles de micro-sandboxes de Linux por segundo en los servidores de control de un clúster GPU genera interrupciones del sistema operativo que degradan el determinismo de la inferencia paralela. La configuración de CPU pura de Helion absorbe la volatilidad de los procesos del sistema operativo, liberando a los aceleradores de cualquier sobrecarga que no sea calcular multiplicaciones de matrices en precisión FP8 o FP4.
Para despliegues corporativos en instalaciones privadas, AMD ha diseñado la segunda variante: un sistema convergente todo en uno. Esta configuración combina nodos de procesamiento EPYC con hasta 16 aceleradores AMD Instinct MI350P en el mismo bastidor, alcanzando 74 petaflops de rendimiento en precisión FP4. La proximidad física entre los núcleos de cómputo general y los aceleradores de inferencia en este modelo reduce la latencia de ida y vuelta durante las llamadas reflexivas, donde un agente evalúa su propia salida antes de emitir la siguiente acción operativa.
El enrutador de tokens integrado como árbitro de inferencia heterogénea
El pilar diferencial a nivel de software dentro de Helion radica en la integración de un enrutador de tokens nativo en el plano de control. En un flujo agentico corporativo típico, no todas las peticiones exigen un modelo de frontera de 400.000 millones de parámetros. Tareas menores como clasificación de intenciones, extracción de entidades o verificación de formato JSON pueden ser resueltas por modelos compactos de 8.000 millones de parámetros alojados localmente en los nodos MI350P, mientras que el razonamiento deductivo complejo se deriva a modelos remotos de vanguardia.
El enrutador analiza la complejidad sintáctica del prompt, la prioridad de latencia asignada al agente y el coste marginal por token antes de despachar la petición. La interconexión física respalda esta flexibilidad con un ancho de banda de red agregado de hasta 102 terabits por segundo, aprovechando tarjetas de procesamiento de red (DPU) Pensando para aplicar políticas de cortafuegos y cifrado mTLS a velocidad de línea sin penalizar a la CPU anfitriona. En términos térmicos, el diseño está certificado tanto para ventilación por aire forzado tradicional como para refrigeración líquida directa al chip (DLC), permitiendo densidades térmicas superiores a 120 kilovatios por bastidor en instalaciones de alta densidad.
Especificaciones Técnicas del Ecosistema Helion
Evaluación de especificaciones, rendimiento y gobernanza en 3 columnas.
Helion Hiperescala
Hasta 32.768 núcleos Zen 6
Procesadores AMD EPYC de 6ª gen
Desacoplada en clúster externo
Flota global de agentes y sandboxes
Helion Corporativo
Híbrido EPYC + Aceleradores
EPYC Zen 6 + 16 Instinct MI350P
74 PFLOPS FP4 integrados
Inferencia privada y agentes locales
Estándar Físico OCP
Open Rack v3/v4 de 44 OpenU
102 Tbps con DPUs Pensando
Aire forzado o líquida directa (DLC)
Cisco, Dell, Supermicro, HPE, Lenovo
El despliegue de agentes en producción plantea fricciones severas en la gestión del coste total de propiedad (TCO) y la latencia del primer token. En arquitecturas tradicionales donde un solo clúster atiende tanto la orquestación como la inferencia, el coste por agente activo se dispara debido a la ineficiencia de retener memoria HBM asignada mientras el proceso espera respuestas de servicios de terceros o interacciones humanas. Los datos de ingeniería de centros de datos revelan que desacoplar la capa de control reduce el coste computacional por paso de ejecución hasta en un 44%, al transferir el consumo de memoria activa desde la costosa memoria HBM3e hacia módulos DDR5 estándar de mayor capacidad y menor coste por gigabyte.
Restricciones de red y cuellos de botella en la sincronización de contexto
La viabilidad de esta topología desacoplada depende críticamente de la latencia del enlace entre los bastidores Helion de orquestación y los grupos de aceleradores. Si la latencia de transporte supera los 15 microsegundos, el beneficio de la especialización de nodos queda neutralizado por la penalización en la transferencia de la caché de claves y valores (KV cache). La ingeniería del clúster exige implementar redes Ethernet sin pérdidas con control de flujo basado en prioridades (PFC) y notificación explícita de congestión (ECN), configuraciones complejas que obligan a los equipos de infraestructura a replantear el tejido de conmutación de nivel Spine-Leaf.
A esta fricción física se suma el cumplimiento regulatorio estricto. En la Unión Europea, las obligaciones derivadas del Reglamento de Inteligencia Artificial para agentes de uso empresarial exigen trazabilidad completa de los registros de auditoría y aislamiento de datos de telemetría. La arquitectura modular de Helion simplifica la contención: los registros de ejecución, trazas de razonamiento y llamadas a herramientas quedan retenidos en el perímetro de cómputo confidencial de los procesadores EPYC, sin necesidad de transferir metadatos sensibles a los motores de inferencia acelerada donde el rastreo granular resulta técnicamente más complejo y costoso.
La disponibilidad comercial de las primeras plataformas basadas en el diseño Helion está fijada para noviembre de 2026 de la mano de integradores ODM y OEM globales. La presión recae ahora sobre los equipos de ingeniería de software, quienes deberán adaptar sus frameworks de agentes para explotar primitivas de hardware disociadas en lugar de programar contra interfaces monolíticas. La batalla por la infraestructura de los centros de datos ya no se mide únicamente en teraflops de cómputo matricial, sino en la eficiencia con la que los vatios disponibles se transforman en decisiones lógicas deterministas.
Impacto Operativo en el Centro de Datos
Métricas de rendimiento y reducción de costes en despliegues a escala
Núcleos CPU por Bastidor
Capacidad máxima en configuración exclusiva EPYC para ejecución simultánea de código.
Coste por Paso de Agente
Ahorro al evitar retención de memoria HBM en esperas de red y llamadas a herramientas.
Capacidad de Conmutación
Tejido de red agregado para sincronización de caché KV y telemetría de inferencia.
Fuentes verificadas
Glosario Técnico


La IA está reescribiendo las reglas. Pensamiento crítico y análisis sin ruido ni titulares vacíos.