China activa su primer superclúster soberano de 100.000 aceleradores
El contexto: China presentó en Shenzhen el despliegue físico del Sugon 8000, su primer superclúster nacional con 100.000 tarjetas aceleradoras integradas en red unificada.
El sistema interconecta 100.000 aceleradores domésticos superando las limitaciones impuestas por el bloqueo comercial internacional.
La arquitectura ejecuta precisión mixta para LLMs y coma flotante estricta para física teórica.
La infraestructura procesa hasta 500.000 tareas diarias reduciendo a la mitad los ciclos de entrenamiento.
«La barrera de las 100.000 tarjetas marca el umbral operativo indispensable para sostener simultáneamente simulación científica pesada y modelos fundacionales autónomos.»
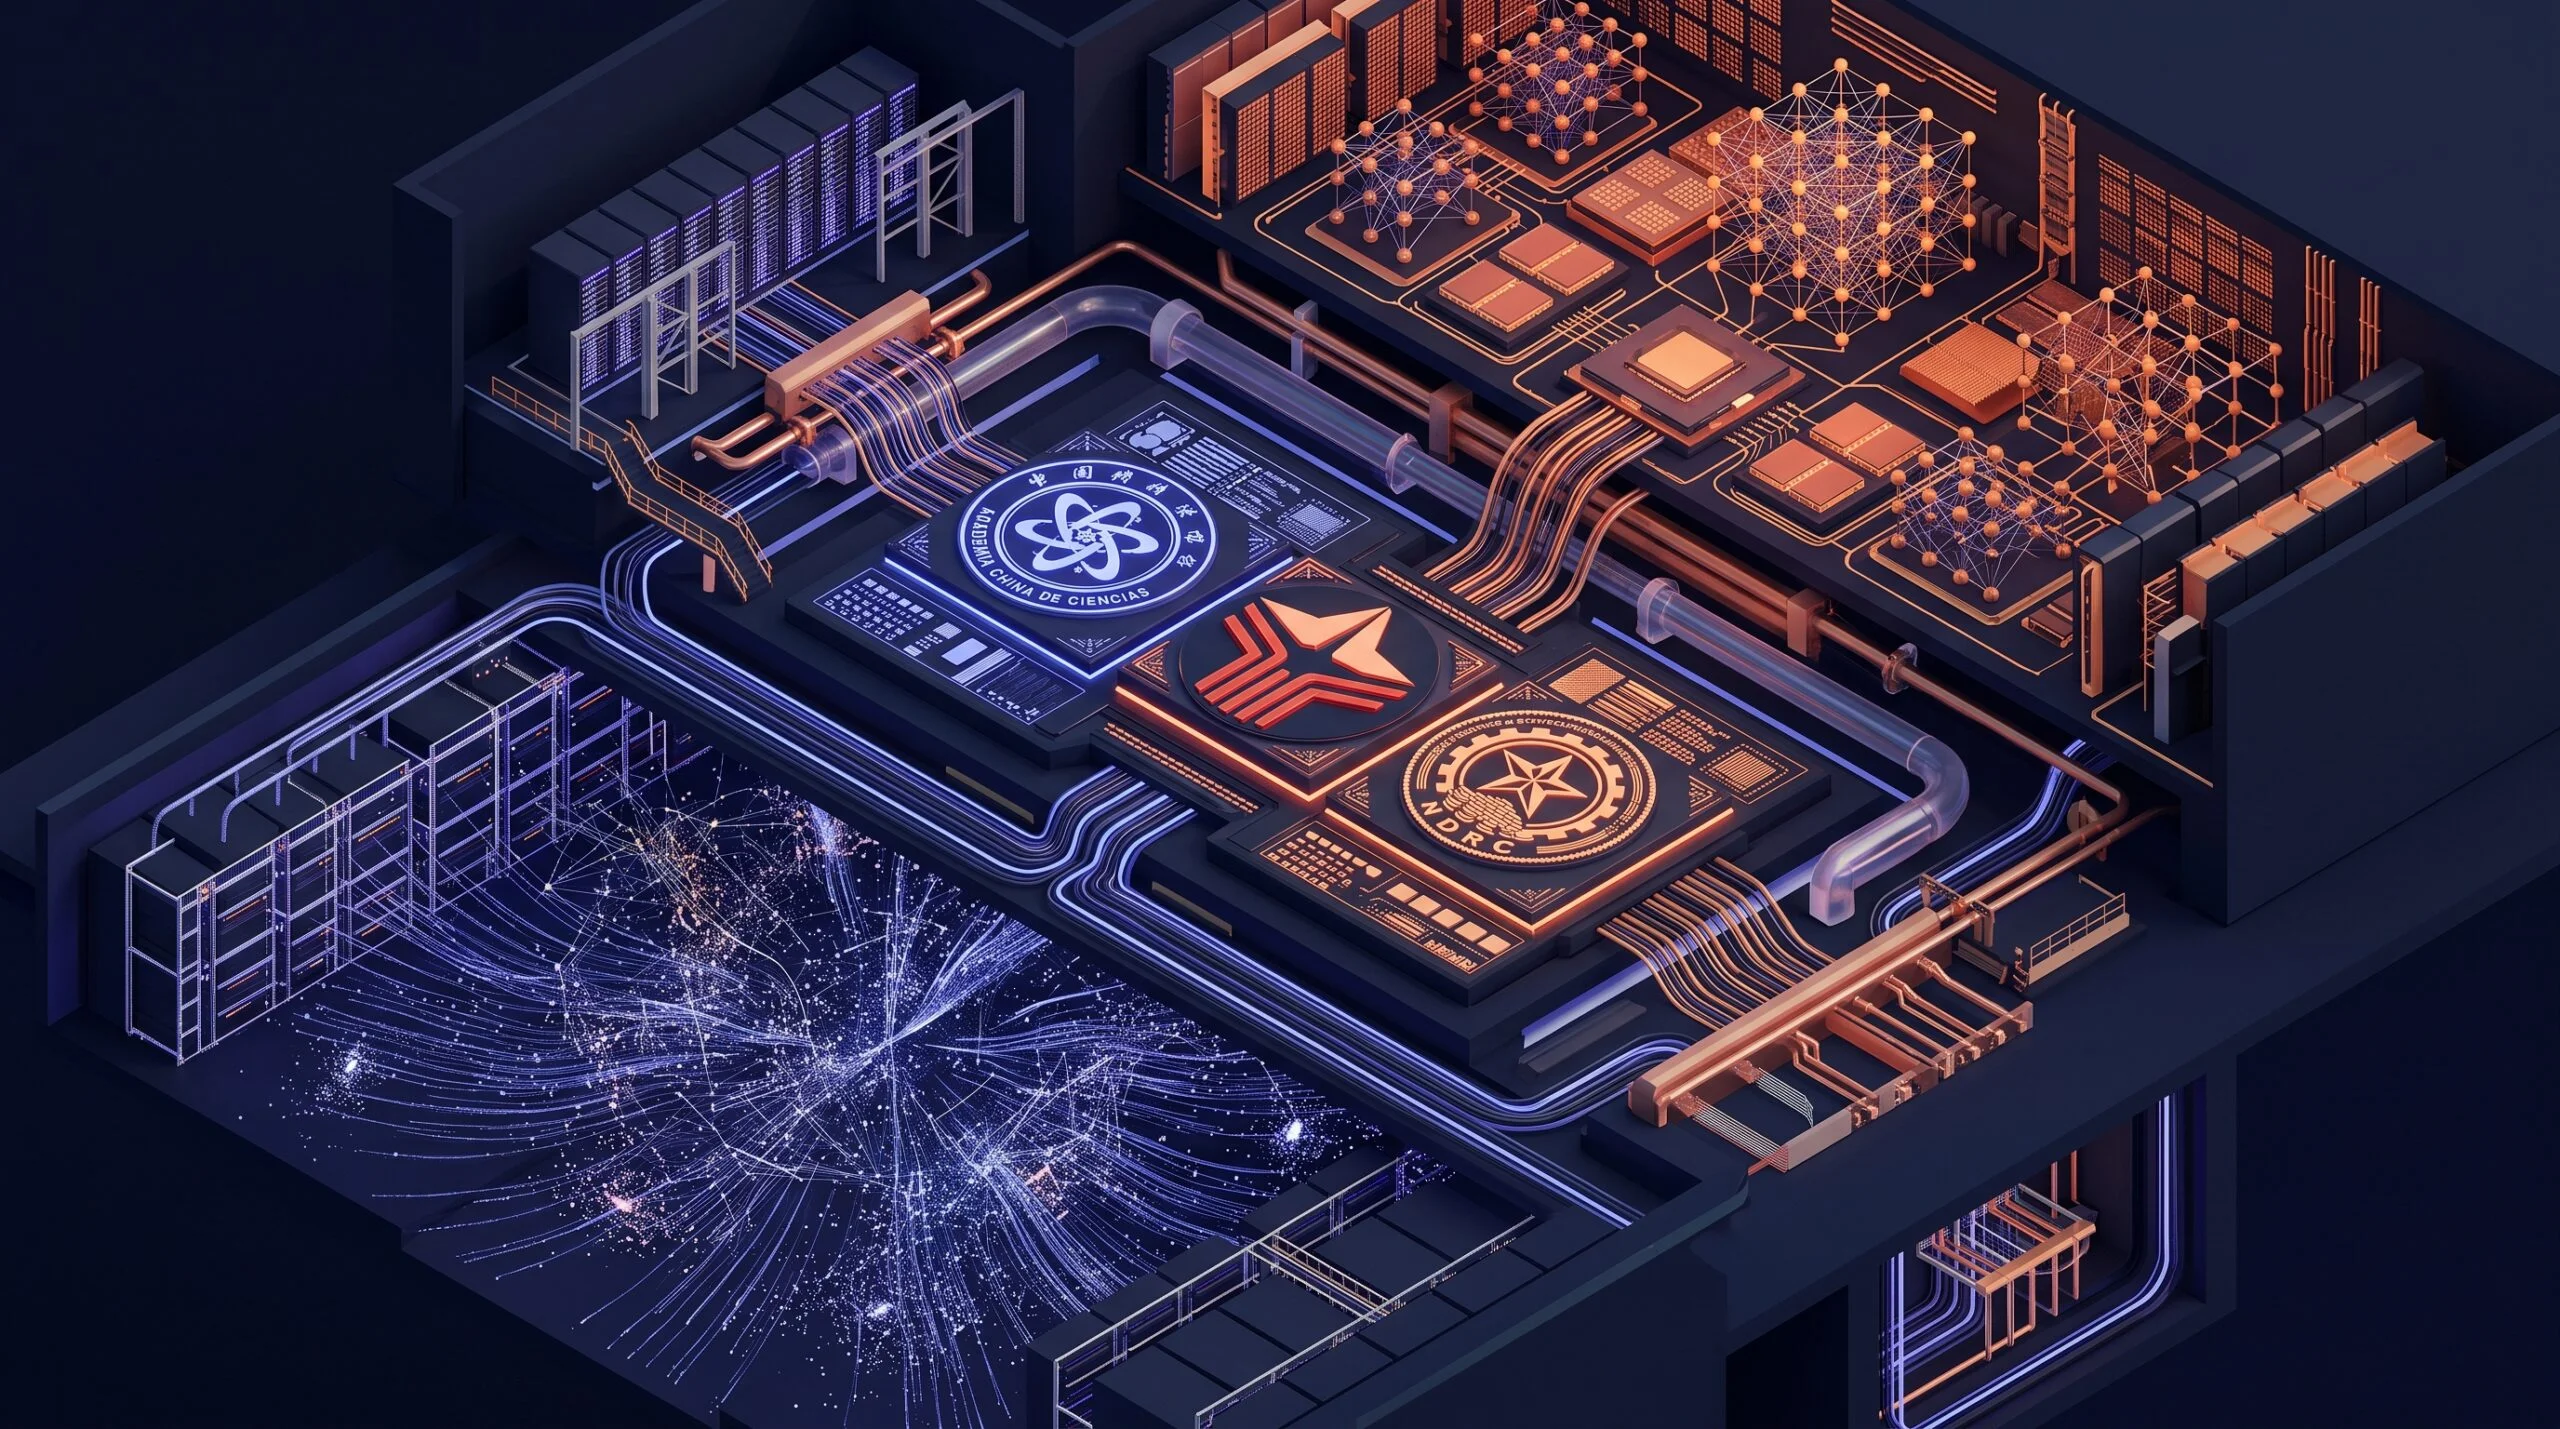
China ha exhibido públicamente la arquitectura física del Sugon 8000, su primer superclúster de inteligencia artificial y computación de alto rendimiento construido íntegramente con componentes de diseño local durante la Conferencia Nacional de Computación de Alto Rendimiento celebrada en Shenzhen. La instalación del nodo central, emplazada en Zhengzhou bajo la supervisión de la Comisión Nacional de Desarrollo y Reforma, interconecta de forma continua más de 100.000 tarjetas aceleradoras heterogéneas, consolidando un tejido unificado que procesa un promedio de 150.000 trabajos diarios de cómputo con picos que ya han alcanzado las 500.000 solicitudes operativas.
La unificación del cálculo científico y las cargas neuronales
La ingeniería detrás de este despliegue rompe la separación tradicional entre los clústeres destinados al cálculo numérico determinista y los centros dedicados al entrenamiento de modelos masivos de lenguaje. Durante décadas, los centros de supercomputación se diseñaron para cálculos de precisión doble de 64 bits gobernados por librerías MPI sobre ecuaciones diferenciales complejas, mientras que la infraestructura de aprendizaje profundo priorizó la velocidad en coma flotante de 16 y 8 bits con densidades masivas de ancho de banda entre tarjetas.
El Sugon 8000 aborda ambos requerimientos en un único plano de silicio y conmutación óptica. Al conectar este nodo a la Red Nacional de Supercomputación de China, que suma 3,5 millones de núcleos de CPU y 250.000 aceleradores gráficos distribuidos, la plataforma atiende a 1,4 millones de usuarios registrados mediante un catálogo que supera las 7.300 aplicaciones industriales y 1.500 modelos fundacionales adaptados. El clúster físico absorbe flujos que van desde el diseño aerodinámico automotriz hasta el entrenamiento de agentes autónomos sin requerir particiones físicas aisladas.
Como remarcó Gao Liang, investigador de los Observatorios Astronómicos Nacionales de la Academia China de Ciencias, «las simulaciones cosmológicas son la clave para resolver el enigma de la evolución estructural del universo, permitiendo reconstruir con precisión milimétrica la interacción gravitatoria entre billones de partículas virtuales». La posibilidad de alimentar estas simulaciones directamente dentro de pipelines neuronales que predicen trayectorias complejas acelera las etapas de inferencia científica a escalas inéditas.
Evolución de la Capacidad de Cómputo Soberano
Ruta de consolidación técnica desde nodos aislados hasta el despliegue del Sugon 8000
1. Era de Clústeres de 10.000 Tarjetas
Aceleración aislada de modelos locales con dependencias de librerías propietarias externas y conmutación básica InfiniBand.
2. Interconexión Nacional Unificada
Conexión de 8 nodos centrales mediante la Red Nacional de Supercomputación integrando 3,5 millones de núcleos de CPU.
3. Despliegue Físico de 100.000 Nodos
Convergencia de fibra multinúcleo, refrigeración líquida directa y silicio acelerador enteramente doméstico.
Infraestructura de 218,5 Exaflops Activa
Procesamiento estable de 500.000 tareas diarias combinando cosmología N-body y preentrenamiento de modelos frontera.
Arquitectura de conmutación óptica y eliminación del cuello de botella en memoria
El salto de una topología de 10.000 nodos a un tejido de 100.000 aceleradores multiplica de forma cuadrática la probabilidad de fallos de hardware y la latencia en las operaciones de reducción colectiva como AllReduce. Para impedir que los procesadores queden ociosos esperando paquetes de sincronización durante la retropropagación de gradientes en modelos de billones de parámetros, los ingenieros implementaron una red de interconexión propietaria desarrollada en el Laboratorio Nacional de Pengcheng, complementada con guías de onda ópticas multinúcleo capaces de cuadruplicar el rendimiento de la fibra monomodo clásica.
La jerarquía de almacenamiento y memoria del sistema opera mediante particiones de acceso directo a memoria remota sobre Ethernet convergente. Esta estructura permite a cada acelerador volcar estados de activación y tensores de pesos sin pasar por las capas intermedias del sistema operativo anfitrión. En operaciones de simulación física masiva, como la recreación cosmológica HyperMillennium, el clúster gestionó 13 petabytes de telemetría continua manteniendo más de 16.000 tarjetas trabajando de forma ininterrumpida durante 18 días consecutivos sin sufrir degradaciones por desincronización de memoria.
Simulación del tejido cósmico y paralelismo de diez billones de partículas
La validación experimental más exigente del superclúster consistió en mapear un volumen espacial de 12.000 millones de años luz mediante el motor de software PhotoNs, optimizado para exprimir el paralelismo de las tarjetas aceleradoras nacionales. La tarea rastreó el comportamiento gravitatorio de 4,2 billones de partículas de materia oscura a lo largo de 13.800 millones de años de evolución temporal cósmica, una carga de trabajo que requirió más de 10 millones de horas de tarjeta aceleradora y 100 millones de horas de CPU.
Los algoritmos tradicionales de árbol de Barnes-Hut y métodos de malla de partículas sufren congestión crítica cuando la densidad de materia colapsa en filamentos galácticos. El entorno unificado del Sugon 8000 resuelve este punto crítico redistribuyendo dinámicamente los subdominios de cálculo entre nodos adyacentes según la concentración de masa simulada, evitando la saturación térmica y computacional en racks aislados.
Este balanceo dinámico de carga, coordinado a nivel de microcódigo, asegura que las diferencias de latencia en la conmutación entre clústeres no interrumpan la consistencia de los datos en tiempo real, habilitando la coejecución de análisis estadísticos neuronales sobre los catálogos galácticos resultantes de manera concurrente.
Módulos Operativos del Superclúster Sugon 8000
Aceleración Heterogénea Soberana
Matrices de cálculo optimizadas para aritmética mixta FP8/FP16 en IA y soporte estricto FP64 para física teórica.
Conmutación Óptica Multinúcleo
Fibra óptica avanzada con 4 canales internos desarrollada para enlazar clústeres a latencia ultrabaja sin jitter.
Tejido de Almacenamiento RDMA
Capacidad de ingesta de 13 petabytes para volcado de gradientes y snapshots cosmológicos sin cuellos de botella.
Orquestación Dinámica Multi-Precisión
Planificación automática que reasigna recursos entre simulación N-body y fine-tuning de LLMs según carga viva.
Rendimiento en ciclo de vida y métricas de producción en modelos fundacionales
El impacto directo de esta densidad de cómputo en la industria de la inteligencia artificial radica en la compresión de los tiempos de desarrollo. De acuerdo con las mediciones oficiales del despliegue en Zhengzhou y su nodo gemelo en la Gran Área de la Bahía de Guangdong, los ciclos completos de preentrenamiento para arquitecturas fundacionales de 1 billón de parámetros han disminuido de aproximadamente 12 meses a 6 meses de procesamiento sostenido. Esta reducción del 50% en el tiempo de salida al mercado altera la economía de experimentación de los laboratorios locales.
Liu Gang, director del Instituto de Investigaciones Económicas de la Universidad de Nankai, explicó que «la integración de la supercomputación clásica con el cálculo inteligente permite distribuir recursos según las demandas matemáticas específicas de cada proceso, multiplicando la eficiencia de uso frente a centros de datos desacoplados». Más de 300 aplicaciones científicas e industriales han sido adaptadas y validadas en el sistema, abarcando desde el modelado molecular para farmacología de precisión hasta el gemelo digital cerebral de alta fidelidad funcional.
Restricciones de litografía y disipación térmica como variables críticas de diseño
La viabilidad de mantener 100.000 aceleradores soberanos operativos depende fundamentalmente del consumo energético y de las tolerancias térmicas. Al no disponer de acceso directo a los nodos litográficos occidentales más avanzados de 3 y 2 nanómetros, las tarjetas domésticas chinas compensan la menor densidad de transistores aumentando el área de silicio y la tensión de funcionamiento. Esta decisión técnica eleva la demanda energética por nodo y exige sistemas de refrigeración líquida por inmersión o placa fría directa en cada rack del centro de datos.
El proyecto nacional de transferencia de recursos computacionales de este a oeste busca absorber este gasto conectando los nodos de inferencia de la costa industrial con las fuentes de generación hidroeléctrica y eólica del interior de China. A finales de junio de 2026, la capacidad de cómputo inteligente de China registró un crecimiento interanual del 177% hasta sumar 218,5 exaflops en precisión reducida, evidenciando que el escalado horizontal mediante decenas de miles de aceleradores interconectados se ha transformado en el estándar técnico que rige su autosuficiencia de infraestructura.
Compromisos Técnicos del Clúster Masivo Heterogéneo
Ventajas Arquitectónicas
- Autonomía completa frente a restricciones de exportación en aceleradores de silicio.
- Reducción del ciclo de entrenamiento de modelos de 1 billón de parámetros de 12 a 6 meses.
- Capacidad para resolver cálculos astronómicos de 4,2 billones de partículas en 18 días continuos.
Fricciones Operativas
- Mayor disipación de calor por mm² debido a litografías menos densas que las occidentales.
- Demanda de sistemas avanzados de refrigeración líquida directa y subestaciones eléctricas masivas.
- Complejidad elevada en compiladores y capas de compatibilidad para 1.500 modelos heterogéneos.
La penalización energética derivada de una litografía más madura se compensa exitosamente mediante escalado masivo en red y orquestación unificada en regiones con energía renovable abundante.
Fuentes verificadas
- Supercomputing plus AI — How China’s first homegrown 100,000-card supercluster could simulate a universe | CGTN
- China’s first homegrown 100,000-card AI super cluster goes live | CGTN
- Reproducing Abell 2744 with the HyperMillennium Simulation (4.2T Particles) | Oxford Academic / MNRAS
- PHoToNs — A Parallel Heterogeneous & Threads oriented code for cosmological simulation | arXiv
- PhotoNs-GPU: A GPU accelerated cosmological simulation code | arXiv
Glosario Técnico


La IA está reescribiendo las reglas. Pensamiento crítico y análisis sin ruido ni titulares vacíos.